Modelos de IA
Qual modelo de IA o atendente usa e quando vale trocar. O modelo não muda o que você paga.
O modelo de IA é o "cérebro" do atendente. É o que efetivamente lê a mensagem, consulta a Base de Conhecimento, e escreve a resposta. Modelos diferentes têm trade-offs entre inteligência, velocidade e custo por mensagem.
Em Playground, no topo da tela do atendente, aparece o seletor Modelo de IA.
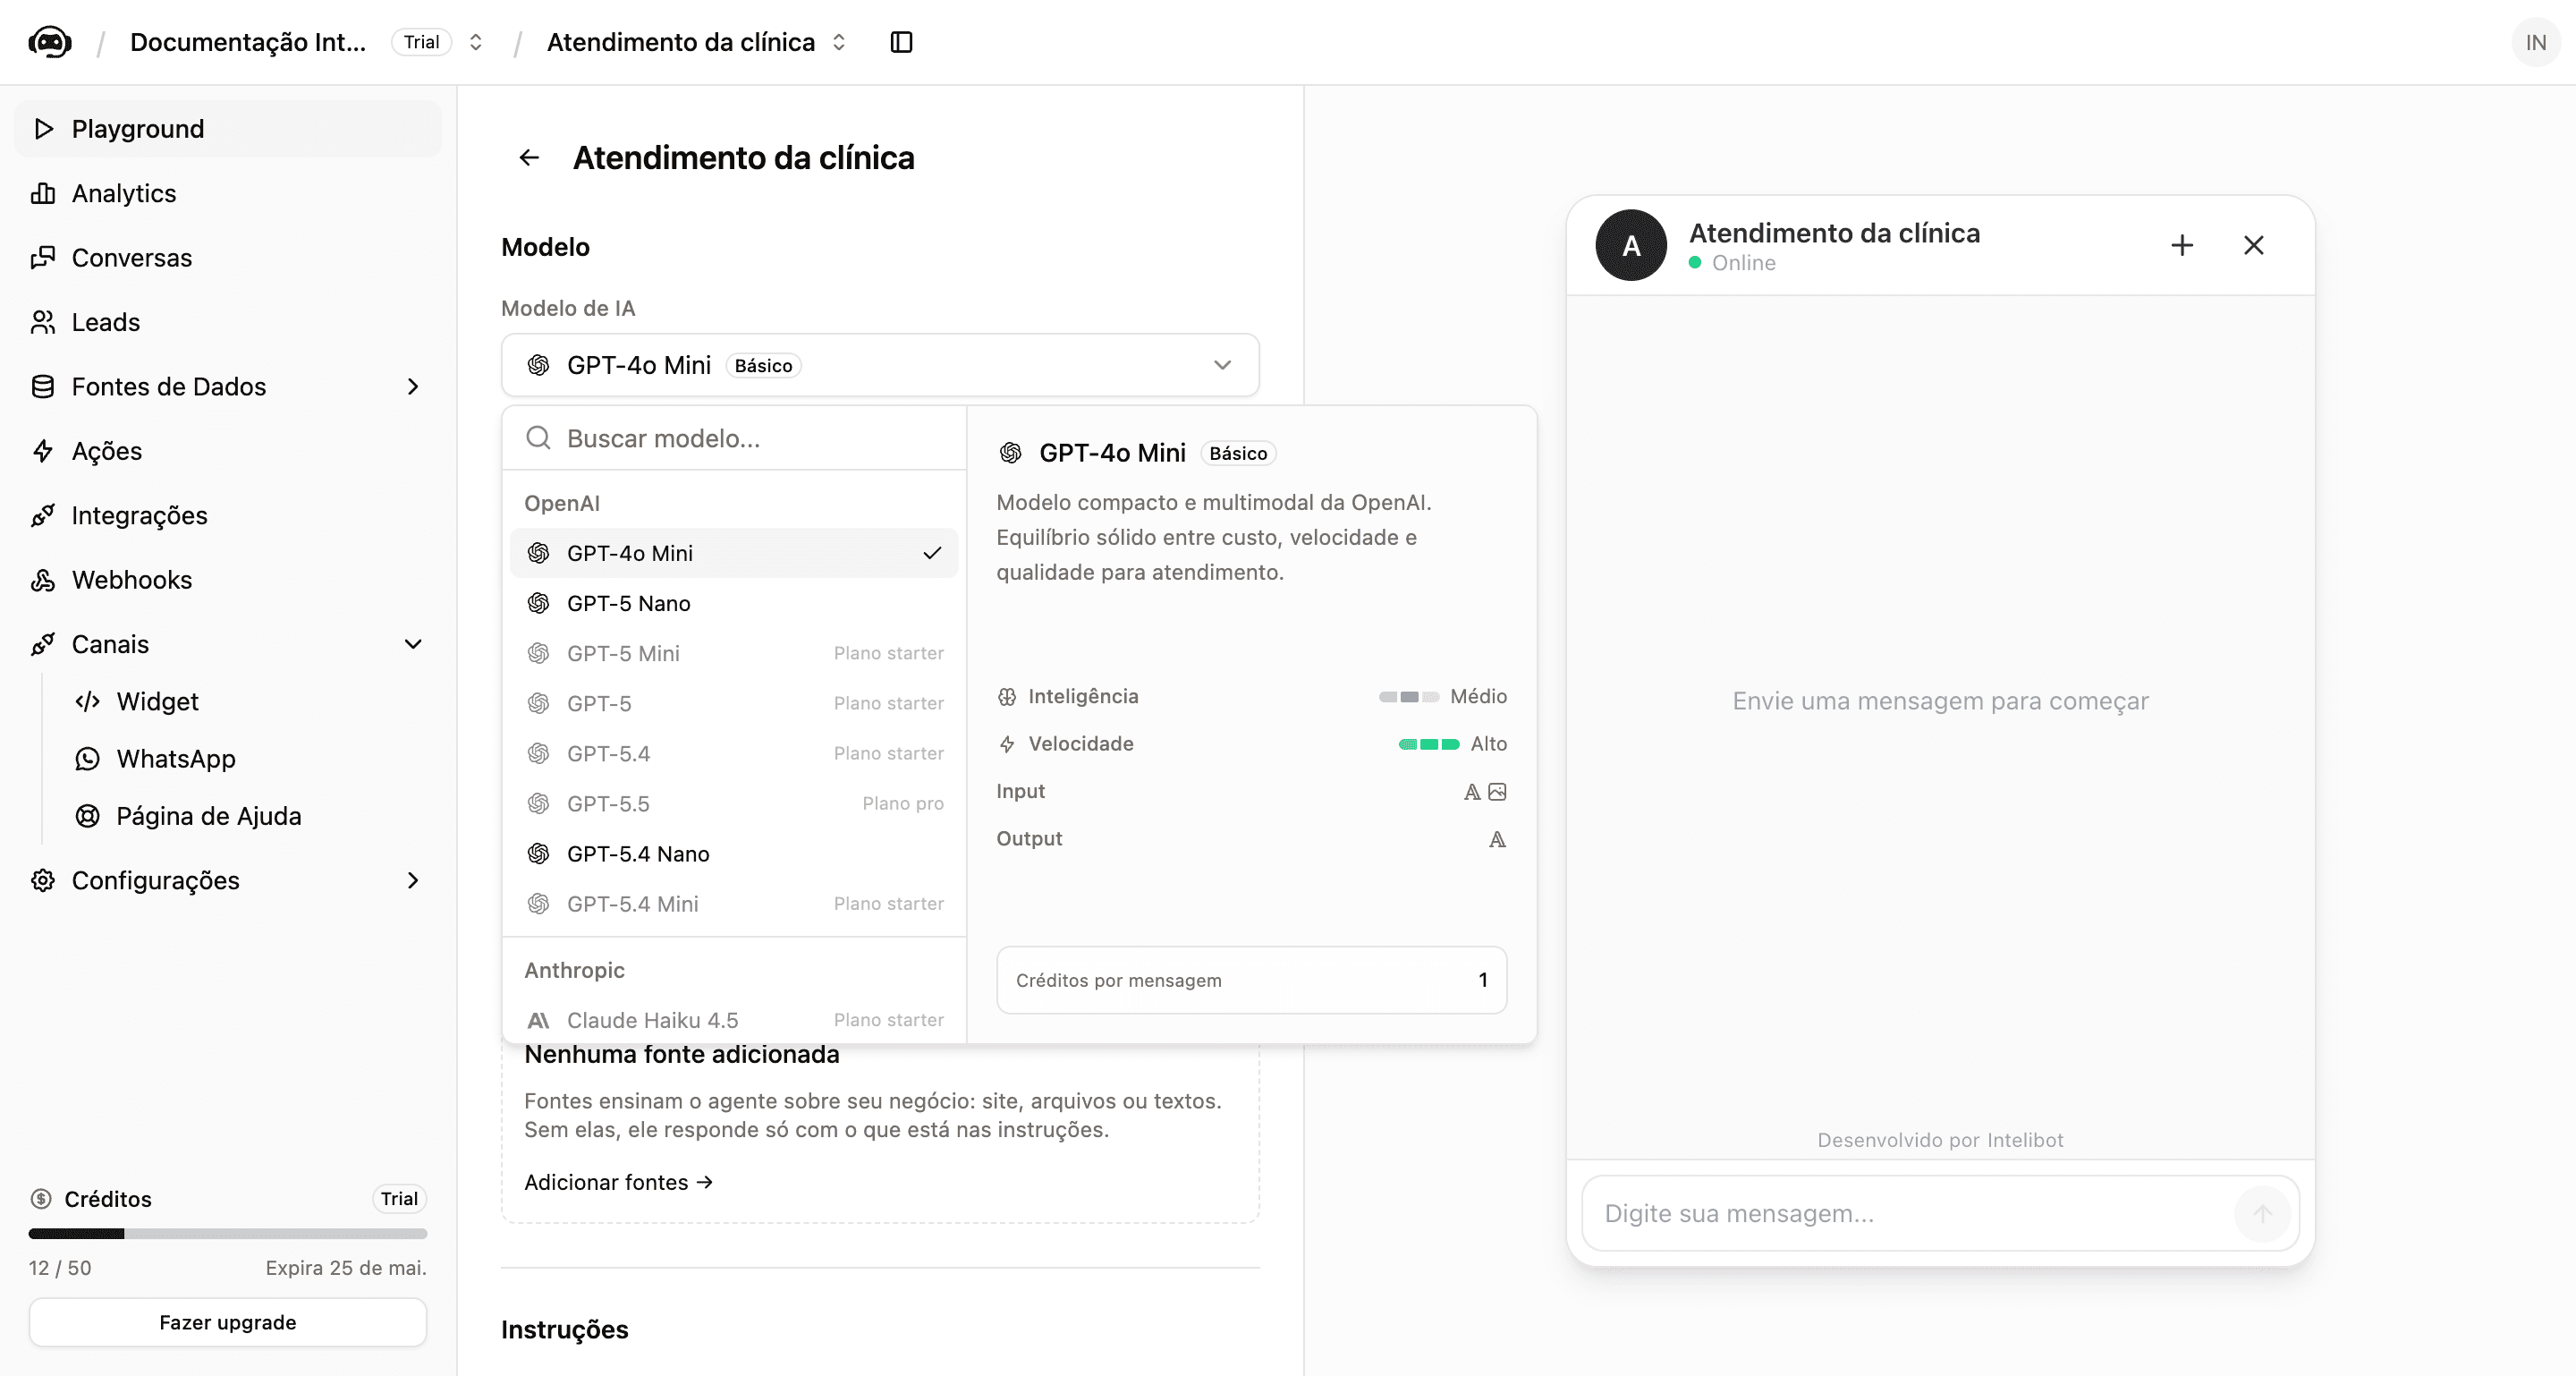
O modelo não muda o que você paga
O preço do Intelibot acompanha o número de assistentes, não o modelo escolhido nem o volume de mensagens. Você pode usar qualquer modelo do catálogo sem que isso altere a fatura.
O que muda entre modelos é qualidade e velocidade da resposta, não custo para você.
Como escolher, então
Comece pelo modelo rápido, que responde em menos tempo e dá conta da maioria das perguntas. Suba para um mais sofisticado se notar o atendente errando em pergunta que exige interpretar contexto — e compare no Playground antes de trocar em produção.
Modelos disponíveis
O catálogo ativo hoje vem de OpenAI e Anthropic. O catálogo evolui com frequência, então a lista abaixo mostra o que estava disponível na última revisão da doc. No painel você sempre vê o catálogo ao vivo.
OpenAI
| Modelo | Tier | Peso | Plano mínimo | Notas |
|---|---|---|---|---|
| GPT-4o Mini | Básico | 1 | Trial | Padrão para atendente novo. Multimodal, equilíbrio bom entre custo, velocidade e qualidade. |
| GPT-5.4 Nano | Básico | 1 | Trial | Substituto recomendado para o GPT-5 Nano. O mais econômico da família 5.4. |
| GPT-5.4 Mini | Básico | 1 | Solo | Substituto recomendado para o GPT-5 Mini. Equilíbrio entre custo e qualidade. |
| GPT-5.4 | Premium | 4 | Solo | Variante intermediária da família 5.4. |
| GPT-5.5 | Premium | 7 | Equipe | Topo de gama da OpenAI. Para atendentes com perguntas complexas. |
Modelos descontinuados
GPT-5, GPT-5 Mini e GPT-5 Nano ainda aparecem no dropdown mas estão marcados como descontinuados pela OpenAI. Se você está usando algum desses, migre para o equivalente da família 5.4 antes que sejam desligados.
Anthropic
| Modelo | Tier | Peso | Plano mínimo | Notas |
|---|---|---|---|---|
| Claude Haiku 4.5 | Avançado | 2 | Solo | Rápido e direto. Ótimo para atendimento conversacional. |
| Claude Sonnet 4.6 | Premium | 4 | Solo | Equilíbrio entre velocidade e raciocínio. Boa para atendentes com Base de Conhecimento maior. |
| Claude Opus 4.7 | Premium | 6 | Equipe | Topo de gama da Anthropic. Para explicações técnicas mais bem feitas. |
O que é a coluna Peso
É quanto cada resposta daquele modelo pesa na conta interna de uso justo — não é preço nem cota de mensagens. Nos planos pagos o atendimento é ilimitado; o peso só existe para identificar uso anormal, e nesse caso falamos com você antes de qualquer coisa. Veja Planos e cobrança.
Qual escolher
Comece com GPT-4o Mini (Básico)
Para primeira versão do atendente, deixe no padrão. É barato, rápido e responde bem em 90% dos casos. Só troque se notar algum problema específico que outro modelo resolve.
Considere trocar para modelo melhor quando:
- O atendente está respondendo bem em conversas simples mas erra em perguntas complexas (ex.: "qual procedimento serve para meu caso?")
- O seu negócio atende casos mais sofisticados (estética avançada, ortodontia adulto, serviços técnicos complexos) onde a explicação técnica importa
- Você quer testar se a qualidade superior compensa o custo extra
Considere trocar para modelo mais barato quando:
- Você está com volume muito alto e o custo está pesando
- A natureza do atendimento é rotineira e direta (ex.: marcação de limpeza)
- Seu atendente tem Base de Conhecimento muito completa, então o modelo "só precisa formatar a resposta"
Atributos que aparecem no painel
Ao escolher um modelo no dropdown, o painel direito mostra:
- Inteligência ou Raciocínio: Baixo / Médio / Alto. "Inteligência" aparece nos modelos comuns; "Raciocínio" aparece nos modelos que suportam pensamento estendido (reasoning).
- Velocidade: Baixo / Médio / Alto. Tempo médio de resposta.
- Input: que tipos de entrada o modelo aceita (texto, imagem ou arquivo). Quase todos aceitam texto; alguns aceitam imagem e/ou arquivo.
- Output: o que ele consegue gerar (texto na maior parte dos casos).
- Créditos por mensagem: o peso da resposta na conta interna de uso justo. Não é cobrança: no plano pago o atendimento é ilimitado, e o preço acompanha o número de assistentes. Um modelo premium pesa mais, mas quem responde 3 vezes mais paga o mesmo.
Trocar o modelo do atendente
Vá em Playground no menu lateral.
No topo, clique no dropdown Modelo de IA.
Escolha o modelo. O painel direito mostra atributos e custo. Se for um modelo de plano superior ao seu, vai aparecer um badge "Plano starter" ou "Plano Pro" indicando que precisa upgrade.
Salva sozinho. Próxima conversa já usa o modelo novo.
Limite de histórico
Abaixo do seletor de modelo, o painel mostra o Limite de histórico (padrão 20 mensagens).
Esse número diz quantas mensagens recentes da conversa o atendente lê antes de responder. Quanto maior, mais contexto ele tem (lembra do que foi falado antes), mas mais lenta e cara fica cada resposta do lado da IA (porque ele processa mais texto a cada turno).
Para atendimento típico, 20 mensagens (~10 trocas) é suficiente. Subir para 40+ faz sentido em casos onde o cliente conversa muito antes de fechar agendamento.
Temperatura
Logo abaixo, aparece o controle de Temperatura (0 a 1, padrão 0.7).
- Temperatura baixa (0 a 0.3): respostas mais previsíveis, fiéis à Base de Conhecimento. Recomendado para negócios que prezam precisão (ex.: valores exatos)
- Temperatura média (0.5 a 0.7): equilíbrio. Padrão
- Temperatura alta (0.8 a 1.0): respostas mais criativas, com mais variação. Pode gerar mais "invenção". Não recomendado para atendimento
Em geral, 0.5 a 0.7 funciona bem. Não precisa mexer.
Próximos passos
Limites do atendente
O que o atendente nunca deve fazer. Lista de proibições explícitas que protegem você, o seu negócio e o seu cliente.
Widget no seu site
Como instalar o botão de chat do Intelibot no site do seu negócio, personalizar aparência e ligar em plataformas como WordPress, Wix, Shopify e Nuvemshop.